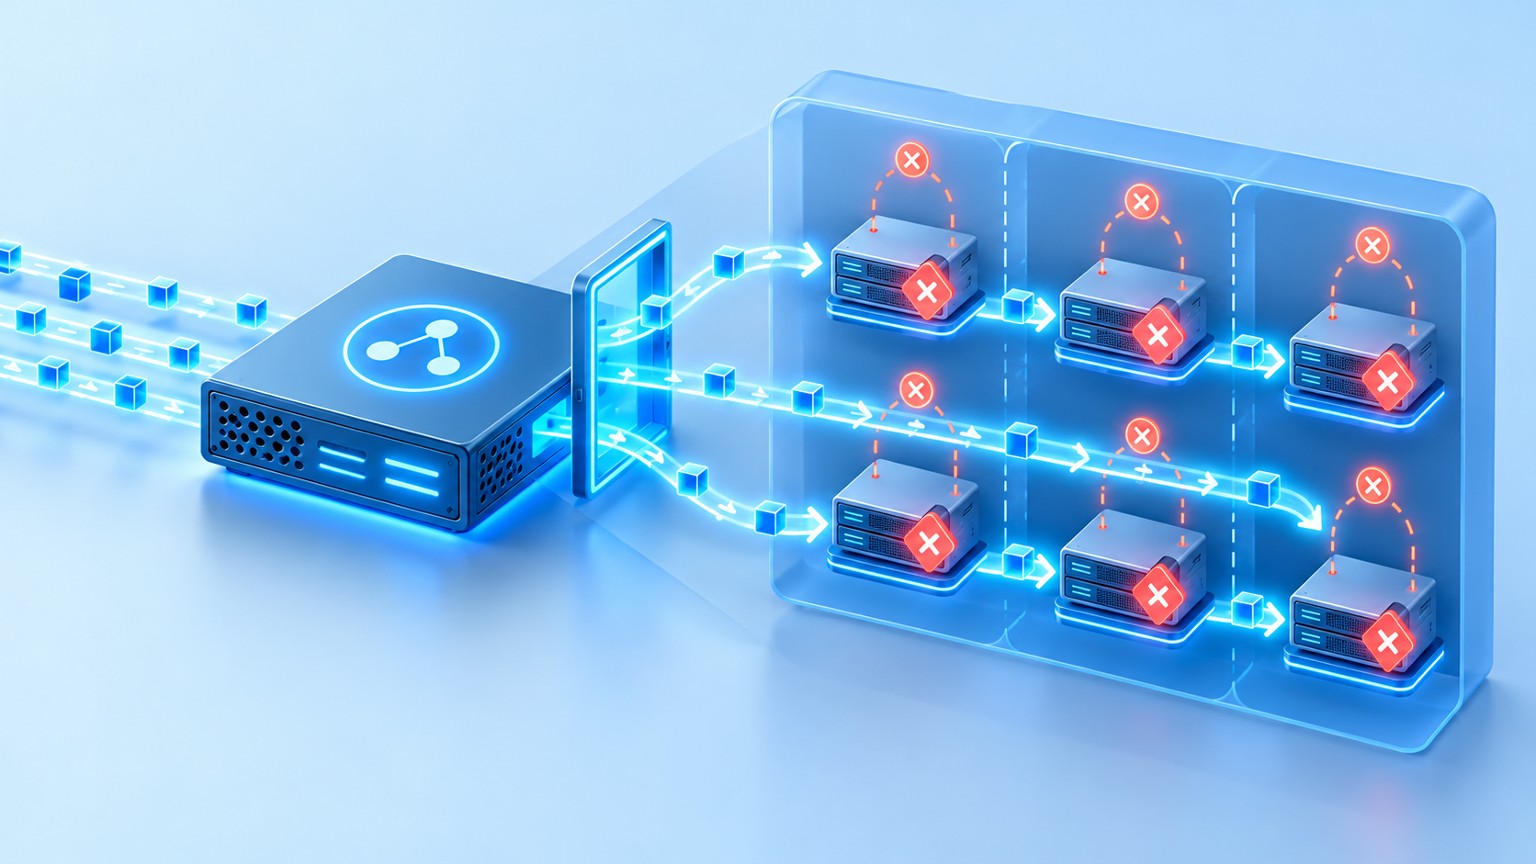
ALB 대상이 모두 unhealthy인데도 요청이 전달된다면, 실제 요청이 향하는 대상 그룹과 활성 가용 영역 전체의 대상 상태를 확인하세요. 대상 그룹에 unhealthy로 판정된 등록 대상만 있고 활성 가용 영역 전체에서 모든 대상이 헬스 체크에 실패하면, ALB는 fail-open으로 동작해 상태와 관계없이 대상에 요청을 전달합니다.
모두 unhealthy일 때는 요청 전달이 계속될 수 있습니다
일반적으로 ALB 노드는 활성화된 가용 영역의 healthy 대상에 요청을 전달합니다. 하지만 대상 그룹의 등록 대상이 모두 unhealthy인 경우에는 예외가 적용됩니다. ALB는 활성 가용 영역의 모든 대상을 대상으로 부하 분산 알고리즘에 따라 요청을 전달합니다.
이것이 fail-open입니다. 요청 전달을 계속 허용하지만, 대상의 헬스 체크 실패를 해결하거나 애플리케이션의 정상 응답을 보장하지는 않습니다. 따라서 대상에 요청이 도착했다는 사실만으로 헬스 체크가 정상이라고 판단해서는 안 됩니다.
대상 그룹과 활성 가용 영역을 순서대로 확인하기
확인하려면 해당 ALB의 리스너 규칙, 활성 가용 영역, 대상 그룹의 등록 대상과 상태를 조회할 수 있어야 합니다. 설정을 변경하기 전에 다음 순서로 관찰 범위를 맞춥니다.
-
문제의 요청에 적용되는 리스너 규칙과 전달 대상 그룹을 확인합니다. 다른 대상 그룹의 상태를 보고 있다면 요청 전달 현상을 설명할 수 없습니다. 전달 대상 그룹이 여러 개라면 각각 확인합니다.
-
ALB에서 활성화된 가용 영역 목록을 확인합니다. 한 가용 영역의 대상만 보고 전체 대상이 실패했다고 결론 내리지 않습니다.
-
해당 대상 그룹의 등록 대상을 가용 영역별로 나열하고 상태를 확인합니다. 활성 가용 영역 전체에서 모든 대상이 unhealthy인지 대조합니다.
-
unhealthy 이외의 상태가 섞여 있는지 확인합니다. 특히 initial이나 unused를 unhealthy와 같은 의미로 묶지 않습니다.
-
대상별 이유 코드와 설명을 기록합니다. 요청이 계속 전달되는 이유와 헬스 체크가 실패하는 이유는 따로 확인해야 합니다.
| 확인한 상태 | 해석 |
|---|---|
| 활성 가용 영역 전체의 대상이 모두 unhealthy | 문서에 설명된 전체 실패 시 fail-open 조건에 해당합니다. |
| 일부 가용 영역만 확인했거나 healthy 대상이 존재 | 모든 대상의 실패를 근거로 fail-open이라고 판단할 수 없습니다. |
| initial | 등록 또는 최초 헬스 체크가 진행 중입니다. 실패 판정과 구분합니다. |
| unused | 리스너 규칙에서 사용되지 않거나 가용 영역이 비활성화된 경우 등이 있으므로 이유 코드를 확인합니다. |
| draining 또는 unavailable | 각각 등록 해제 진행 또는 헬스 체크 비활성 상태입니다. unhealthy로 계산하지 않습니다. |
예시: 두 가용 영역의 대상이 모두 실패한 경우
다음은 실제 실행 결과가 아닌 설명용 상황입니다. ALB는 가용 영역 A와 B를 활성화했고, 문제의 리스너 규칙은 대상 그룹 web-tg로 요청을 전달한다고 가정합니다. 두 대상은 이전에 최초 헬스 체크를 통과해 요청을 받던 상태이며, 등록 해제 중인 대상은 없습니다.
| 대상 그룹 | 대상 | 가용 영역 | 현재 상태 |
|---|---|---|---|
| web-tg | web-a | A, 활성 | unhealthy |
| web-tg | web-b | B, 활성 | unhealthy |
이 구성이며 두 대상 모두 헬스 체크 실패로 unhealthy가 되었다면, 예상되는 동작은 fail-open입니다. ALB는 web-a와 web-b를 요청 전달 대상에 포함하고 부하 분산 알고리즘에 따라 선택합니다. unhealthy인 web-a에 요청이 도착하더라도 문서에 설명된 동작과 모순되지 않습니다.
반면 B 영역의 상태를 확인하지 않았다면 판단은 보류해야 합니다. 또한 web-b가 unused이고 이유가 비활성 가용 영역이라면, 이를 두 활성 가용 영역의 대상이 모두 실패한 사례로 해석할 수 없습니다.
요청 전달과 서비스 복구를 혼동하지 않기
- fail-open은 요청을 전달하는 동작입니다. 응답 성공, 응답 시간, 특정 대상에 대한 균등 분배를 보장하지 않습니다.
- 대상이 하나도 없는 대상 그룹과 등록 대상이 모두 unhealthy인 대상 그룹은 다른 조건입니다. 빈 대상 그룹까지 이 설명을 확장하면 안 됩니다.
- 대상 상태는 헬스 체크 주기와 연속 성공·실패 임계값에 따라 판정됩니다. 서로 다른 시점의 상태와 요청 기록을 비교해 fail-open을 단정하지 않습니다.
- 요청이 계속 들어오더라도 실패 이유는 확인해야 합니다. 대상별 이유 코드와 헬스 체크 설정을 대조하고, 복구 후에는 연속 성공 조건을 충족해 healthy로 돌아오는지 확인합니다.
실무에서는 요청에 적용된 대상 그룹, 활성 가용 영역, 대상별 상태와 확인 시각을 함께 기록하세요. 그 범위에서 전체 unhealthy가 확인되면 요청 전달을 fail-open으로 해석하고, 별도로 헬스 체크 실패 원인과 정상 상태 복구를 추적하면 됩니다.